Scrapy代理配置怎么做?请求级设置与排错
Agent IP information2026-10-13T00:41:54
Scrapy代理既可以通过
request.meta["proxy"]先分清Scrapy代理由哪一层控制
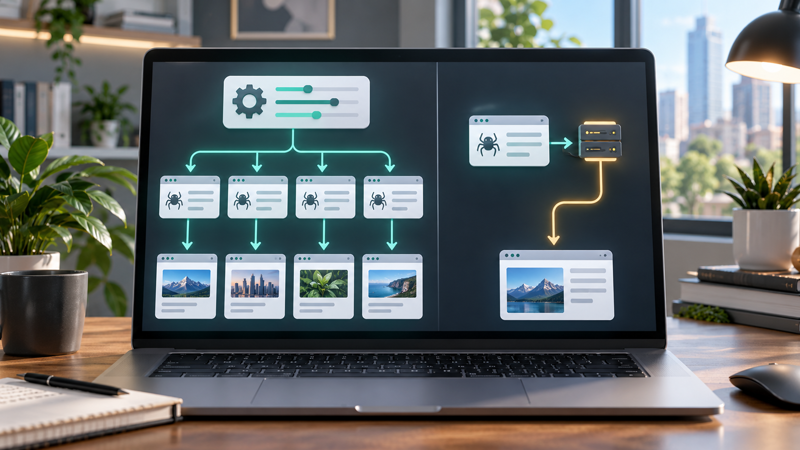
Scrapy 官方下载中间件文档把请求对象、HttpProxyMiddleware 和下载处理器分成不同层。Request 保存可选的代理 URL;中间件读取请求设置或适用的环境变量;下载处理器负责建立连接,并可能带有协议限制。排错时要逐层确认,不能认为一个代理字符串能解释所有行为。
| 作用范围 | 配置位置 | 适合的任务 |
|---|---|---|
| 单个请求 | | 最小测试或指定公开页面 |
| 单个爬虫或进程 | 用统一辅助函数构造 Request | 显式控制项目逻辑和日志 |
| 运行环境 | | 由部署环境管理默认端点 |
| 处理器能力 | | 在排查认证前确认协议兼容性 |
方法一:只给一个Request配置代理
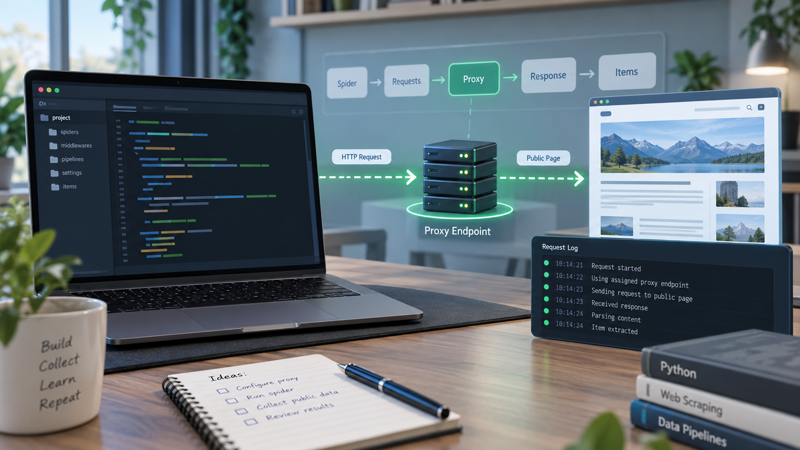
最小测试应当只有一个 Request、一个虚构文档端点和一个获得授权的公开目标。运行时再把端点替换成实际分配值,同时设置超时,并记录状态码、最终 URL 和请求标识。不要一开始就提高并发,否则重试、限速和目标站行为会混进一个原本简单的连接测试。
最小请求可以拆成下面五段简短的 Python 片段:
常见问题
单个Scrapy请求在哪里配置代理?
在该请求的 request.meta["proxy"] 中填写已分配的代理 URL。请求级设置会覆盖相应环境变量。
Scrapy可以读取环境变量里的代理设置吗?
可以。HttpProxyMiddleware 可以读取 http_proxy、https_proxy 和 no_proxy,但最终行为还取决于项目配置和下载处理器。
Scrapy项目应该怎样保存代理账号密码?
运行时从环境变量或密钥管理系统读取,不要把用户名、密码或包含凭证的完整 URL 提交到代码仓库。
所有Scrapy下载处理器的代理能力都一样吗?
不一样。官方文档明确列出处理器差异,例如内置 HTTP/2 处理器不支持代理,SOCKS 或 HTTPS 代理也取决于处理器。